AIへの指示は、長く細かく書くほど精度が上がる。私もずっとそう思っていました。
だから、うまくいかないたびにルールを1行ずつ足してきました。禁止事項を増やし、手順を書き足し、例外を追記する。ところがある時点から、足しても手応えが変わらなくなります。どこに何を書いたのか、自分でも分からなくなってきました。似た感覚に心当たりはないでしょうか。
結論から書きます。AIに渡すルールは「増やすもの」から「どこに置くかを決めるもの」に変わりました。この考え方が、いまコンテキストエンジニアリング(Context Engineering)と呼ばれています。
先に一つ。これは「プロンプトエンジニアリングはもう古い」という話ではありません。むしろ逆で、書き方はこれからも効きます。
Anthropicがシステムプロンプトの8割を削った
2026年7月24日、Anthropicが「Claude Opus 5」を公開しました。同じ日に、同社のブログでもう一本の記事が公開されています。タイトルは「The new rules of context engineering for Claude 5 generation models」。著者はAnthropicのThariq Shihipar氏です。
この記事に、次の趣旨の一文があります。Claude Opus 5やClaude Fable 5のようなモデル向けに、Claude Codeのシステムプロンプトの80%以上を削除したが、社内のコーディング評価では計測できる性能低下がなかった、というものです。
ここは誤解されやすいので先に整理します。8割を削ったのはAnthropic自身で、削られたのは同社が開発するClaude Codeのシステムプロンプトです。私が自分の環境で8割削った、という話ではありません。
システムプロンプトとは、AIに毎回渡している前提の指示文です。「こういう役割で、こういう手順で動いてください」と最初に書いておく部分です。
コンテキストエンジニアリングとプロンプトエンジニアリングの違い
Anthropicは以前にも、コンテキストエンジニアリングについて「Effective context engineering for AI agents」という記事を公開しています。そこでの定義は、推論の最中に、最適な情報の集合を選び、保ち続けるための戦略のまとまり、という位置づけです。
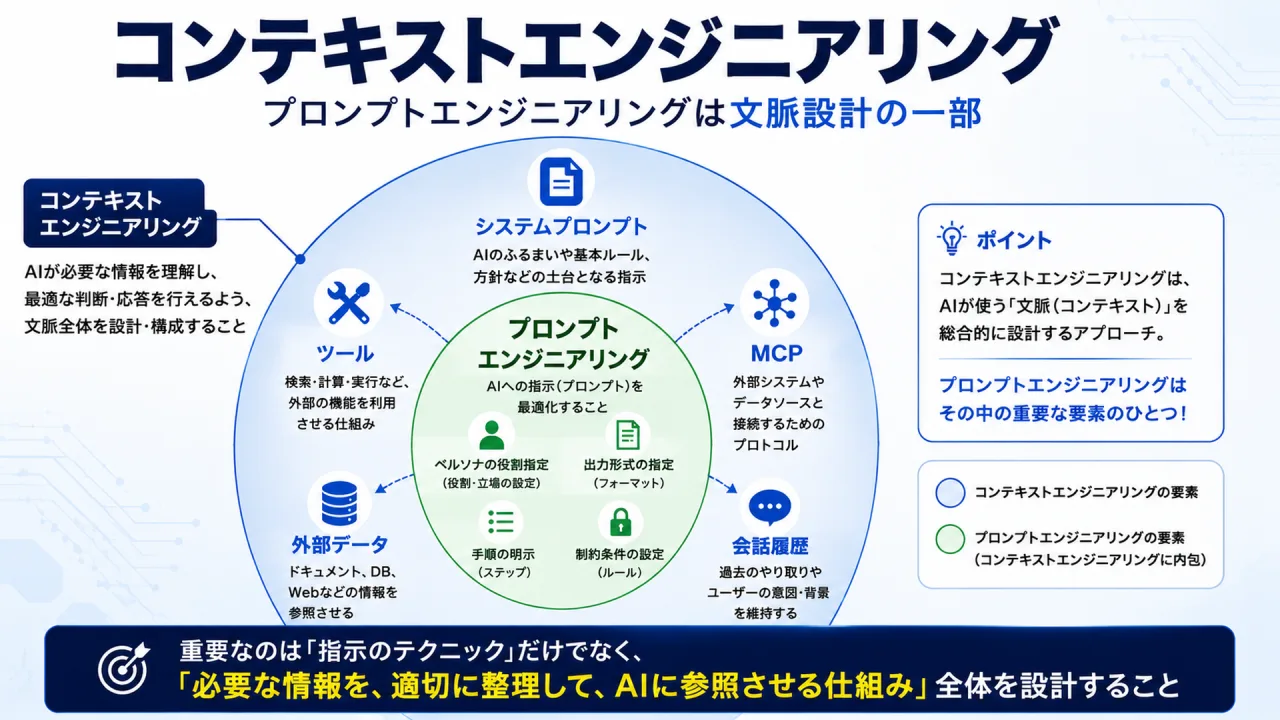
プロンプトエンジニアリングとの違いは、扱う範囲にあります。公式の説明では、プロンプトエンジニアリングは主に「どう書くか」に焦点があります。一方コンテキストエンジニアリングは、システム指示、ツール、MCP(AIが外部のツールやデータへ接続するための共通の仕組み)、外部データ、会話履歴まで含めた文脈全体の管理を対象にしています。
つまり、置き換えではありません。プロンプトの書き方は、より大きな設計の一部として中に含まれています。
自分のCLAUDE.mdを数えたら82行だった
公式の発表を読んで、気になったのは自分の環境でした。私はブログ運営の知識をクラウド上のフォルダにまとめ、Claude Codeから読ませています。その入口がCLAUDE.mdです。
AIに毎回読ませる前提のルールを書く場所なので、実質的には自分で書いたシステムプロンプトにあたります。
実際に数えてみると、2026年7月31日時点で82行、5,827文字でした。
正直、拍子抜けしました。
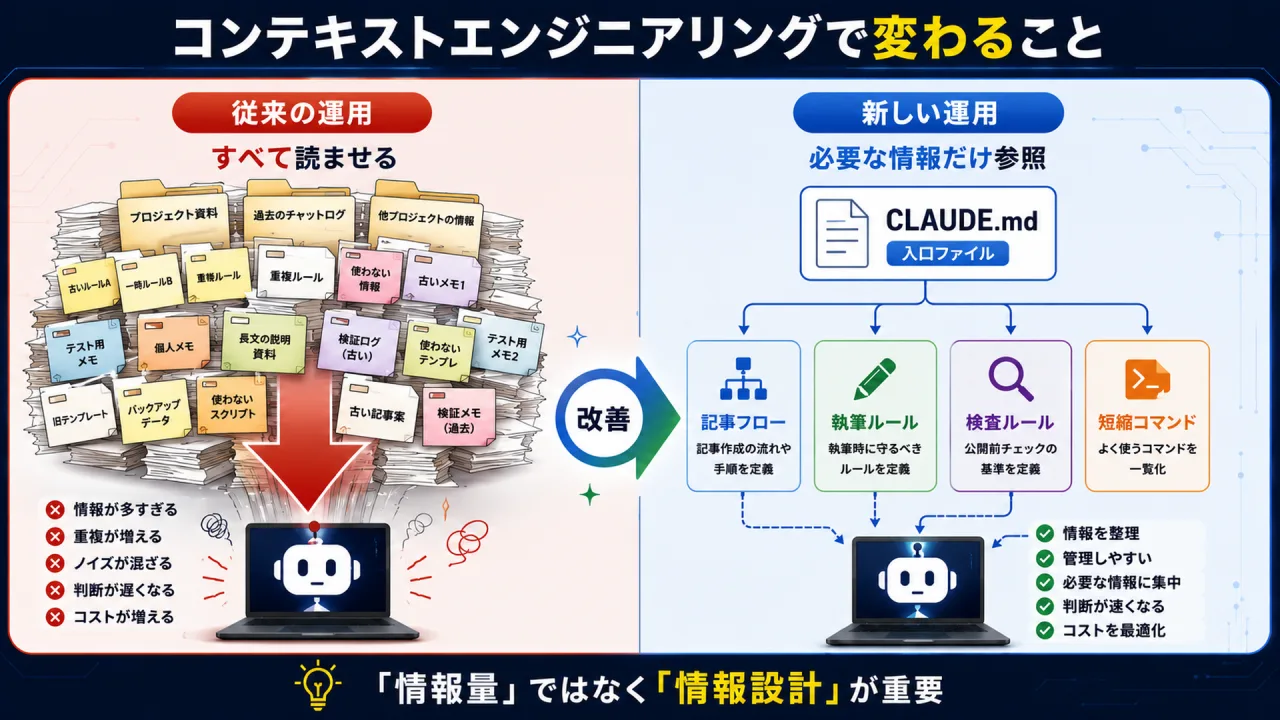
なぜ82行で済んでいたのか。理由ははっきりしていて、細かいルールをこのファイルへ書かなかったからです。
最初は全部ここに書くつもりでした。ただ、記事を1本書くだけでも、執筆中に守ること、検査で確認すること、WordPressを操作するときの手順と、性質の違うルールが並びます。それを1枚のファイルへ積み上げると、記事を書いていないときにも検査の細部まで読ませることになります。逆に、あとから1項目だけ直したいときに、どこを触れば他へ影響しないのかが分からなくなりました。
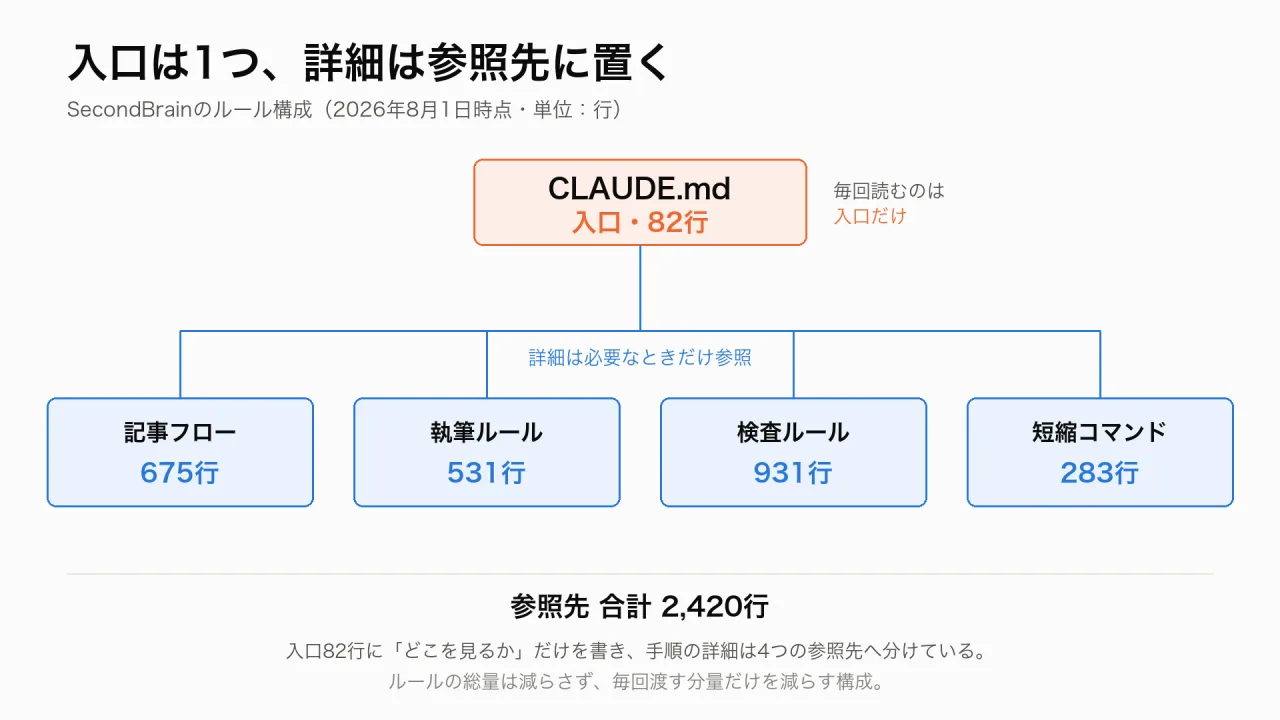
そこで、執筆・検査・フロー・短縮コマンドの4つに分けて別ファイルへ移し、CLAUDE.mdに残したのは「どんな指示が来たら、どのファイルを見るか」だけにしました。判断の入口と、参照先の案内板に絞った、という言い方が近いと思います。
ルールは「渡す」ではなく「参照させる」形になっていた
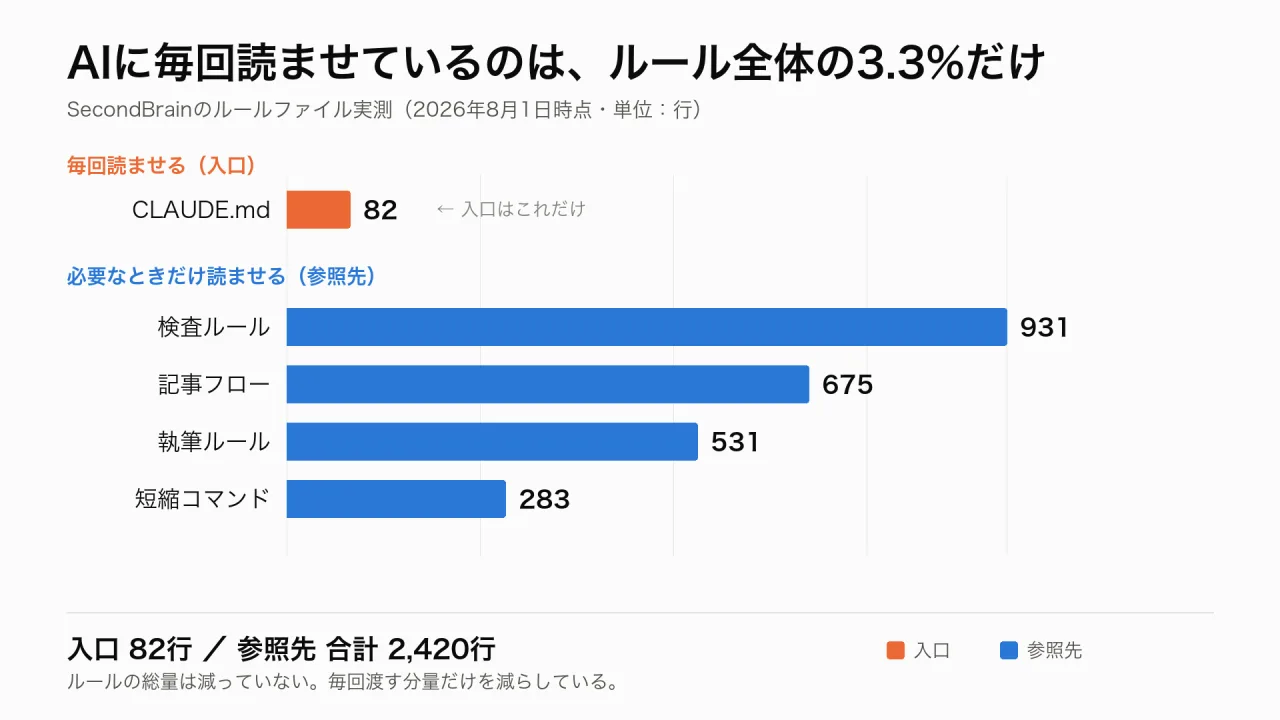
では、別ファイルへ移した分はどれくらいの量なのか。数えると、記事フローが675行、執筆ルールが531行、検査ルールが931行、短縮コマンド表が283行。合わせて2,420行ありました。いずれも2026年8月1日時点の数字です。
入口が82行で、その先に2,420行。ルールの総量はまったく減っていません。減ったのは、毎回必ず読ませている分量だけです。
公式記事が挙げている変化の一つに、必要な情報を最初に全部渡すのではなく、段階的に開示していくという項目があります。自分の構成は、狙ってそうしたわけではありません。ファイルが長くなりすぎて分割しただけです。ただ結果として、公式が紹介している考え方と似た構成になっていました。
ただし、同じ仕組みを使っているわけではありません。公式が示しているのは製品側の設計の話で、こちらはファイルの置き方を変えただけです。
それでもプロンプトの書き方は消えない
私の手元には、Anthropicが公開しているプロンプトの基本を整理したメモが残っています。変わらない情報はシステムプロンプト側に置く。複雑な作業は手順を分けて指定する。出力形式をあらかじめ決めておく。この3つです。
実際に使ってみると、いまも効きます。特に「出力形式を先に決める」と「手順を分けて指定する」は、記事の検査工程をAIに任せるときに差が出ます。形式を決めないまま投げると、結果が毎回違う形で返ってきて、結局こちらが読み直すことになります。
コンテキストエンジニアリングは、これらを不要にする考え方ではありません。どこに、どれだけ渡すかという設計が上に乗っただけです。
今日から見直せる3つのこと
公式の発表をそのまま真似する必要はありません。個人で使う範囲なら、次の3つから始められます。
1. 指示を足す前に、置き場所を疑う
AIの出力がずれたとき、まずルールを1行足したくなります。その前に、足したい一文のキーワードで、ルールを置いているフォルダ全体を検索してみてください。「禁止」「必ず」「しない」あたりで引くと、同じ意味の行がいくつも出てくることがあります。重複が見つかったら、書き足す前に、どれを正本にしてどれを消すかを先に決めます。この順番にするだけで、行数が増えずに済むことが何度もありました。
2. 毎回渡す情報と、必要なときだけ読ませる情報を分ける
毎回読ませるファイルには、判断の入口と参照先だけを書き、手順の詳細は別ファイルへ置きます。分ける基準は「どの作業でも必ず要るか」です。公開してよい条件や、勝手に実行させない操作といった安全に関わるものは入口に残します。特定の作業でしか使わない手順やチェック項目は別ファイルへ移し、その作業の指示が来たときだけ読ませます。
3. 会話をまたぐ記憶は、ルール本体から切り離す
公式記事では、CLAUDE.mdに記憶を書き溜める形から、自動的な記憶の仕組みへ、という変化も挙げられています。私も、会話をまたいで覚えておいてほしい内容は、ルールファイル本体ではなく記憶用の仕組み側へ置くようにしています。切り分けの基準は「次の作業でも守るルールか、それとも今回だけの事情か」です。特定の記事の番号や、一度きりの例外対応をルールファイルへ書き込むと、あとで読み返したときに、どれが恒久ルールなのか判別できなくなります。
まとめ
分かったことを整理します。Anthropicは自社製品のシステムプロンプトを8割以上削り、コーディング評価では計測できる性能低下がなかったと公表しました。ここまでが一次情報です。私の側は8割削ったのではなく、もともと入口が82行で、詳細が別の場所に2,420行あっただけでした。
それでも、確認したことには意味がありました。「指示を足し続けている感覚」の正体が、量ではなく置き場所の問題だと分かったからです。
もし同じもやもやがあるなら、最初の一歩は簡単です。自分がAIに毎回読ませているファイルが何行あるか、数えてみてください。思っていたより短いか、長いか。どちらでも、次に手を入れる場所が見えてきます。